0 前言
测井资料具有连续、分辨率高、成本可控等优势,是储层评价与含油性识别的重要信息来源。近年来,深度学习与Transformer结构在地学数据建模中的渗透,为测井智能解释提供了新路径。胡睿等[1]的研究表明,结合注意力机制的序列建模能够在多测井输入条件下提升储层参数预测能力;He等[2]通过掩码编码器为测井数据的解释提供了新的思路;也有学者进一步探索了大模型范式用于含水饱和度预测的可行性[3-5]。Devlin等[6]通过双向Transformer与掩码预训练框架,为“先预训练、后微调”的技术路线奠定了基础。然而,在低含油饱和度砂岩储层等复杂的地质条件下,传统监督学习仍面临三重瓶颈:其一,标注数据稀缺且存在测井解释偏差;其二,曲线缺失、噪声与跨区块差异导致模型泛化不稳;其三,单纯监督训练难以充分利用海量未标注测井数据[7-9]。为应对上述挑战,自监督表征学习逐渐成为关键突破口。Zholobov等[10]提出集成式自监督模型,强调“无标签预训练”对下游任务性能的支撑作用;翟晓岩等[11]通过注意力与二维卷积实现测井曲线重构,反映出测井曲线缺失、噪声与采集差异对预测精度的直接影响。Zerveas等[12]给出了多变量时间序列表征学习框架,为“掩码自监督Transformer”迁移到测井曲线建模提供了结构参考。此外,多任务多目标约束[13-17]与对比学习策略[18-19]也进一步拓展了自监督信号的构建维度;Zhou等[20]提出长序列预测为测井长深度剖面序列的建模带来启发;测井曲线生成与补全技术[21-23]则从数据增强角度为下游预测提供了支撑。
1 理论与方法
本次研究针对测井含油饱和度预测难题,建立深度域连续回归模型,输出${S}_{o}\in \left[\mathrm{0,1}\right]$的随深度变化曲线。提出“两阶段学习框架”:先通过MWLT(Masked Well-Log Transformer)自监督预训练在无标签测井序列上学习通用表征,再通过MWLT-So监督回归微调在有标签或代理标签的样本上学习So映射。该框架能够在不依赖大量人工解释成果的情况下提取地层连续性与多曲线协同变化规律,提高So预测的稳定性与跨井可迁移性。
1.1 任务定义与测井序列表征
将井中测井曲线视为以深度z为自变量的多变量序列。对任意深度z,构造输入特征向量:
$x\left(z\right)={\left[\begin{array}{c}DEN\left(z\right),\hspace{0.25em}CNL\left(z\right),\hspace{0.25em}AC\left(z\right),\hspace{0.25em}{R}_{t}\left(z\right),\hspace{0.25em}GR\left(z\right)\end{array}\right]}^{\top }\in {R}^{F}$
式中:x(z)表示深度z处的测井观测,DEN为体密度,CNL为中子孔隙度,AC为声波时差,Rt为电阻率,GR为自然伽马,F为特征维数,取值为5。
由于电阻率Rt(z)常跨越多个数量级,若直接进入模型会导致数值尺度主导优化过程并削弱其他曲线的贡献,因此对其进行对数变换:
${{R}_{t}}^{\text{'}}\left(z\right)=lo{g}_{10}\left(max\left({R}_{t}\left(z\right),\epsilon \right)\right), \epsilon > 0$
式中:Rt'(z)为变换后的电阻率特征,ε为防止对数奇异的极小正数。后续建模时以Rt′替代Rt,以获得更平滑、更接近高斯分布的输入尺度。
测井采样深度往往不等距且存在缺失点。为使模型能够在统一的深度分辨率上学习层序连续性,构造等间隔深度网格:
${\tilde{z}}_{k}={z}_{min}+k\Delta z, k=\mathrm{0,1},\dots,K$
式中:zmin为该井有效深度范围的下界,Δz为重采样步长,k为网格索引,K为网格总数。对任意曲线,采用插值函数获得等距序列:
$\tilde{g}\left({\tilde{z}}_{k}\right)=Interp\left({\left\{\left({z}_{i},g\left({z}_{i}\right)\right)\right\}}_{i=1}^{N}, {\tilde{z}}_{k}\right)$
式中:${\left\{\left({z}_{i},g\left({z}_{i}\right)\right)\right\}}_{i=1}^{N}$表示原始采样点集,Interp(·)为插值算子,$\tilde{g}\left({\tilde{z}}_{k}\right)$为重采样后的曲线值。该操作保证不同井之间在输入长度与深度分辨率上更易对齐,减少由采样差异引入的学习偏差。
考虑到测井曲线中常存在尖峰与异常段,为降低异常值对优化目标的影响,增强跨井分布一致性,对每个特征维度采用鲁棒归一化:
${\widehat{x}}_{f}=\frac{{x}_{f}-median\left({x}_{f}\right)}{IQR\left({x}_{f}\right)}, IQR\left({x}_{f}\right)={Q}_{75}\left({x}_{f}\right)-{Q}_{25}\left({x}_{f}\right)$
式中:xf表示某一特征维度的原始数值,${\widehat{x}}_{f}$表示归一化后的数值,median(·)为中位数,Q75(·)与Q25(·)分别为75%与25%分位数,IQR为四分位距。与均值方差标准化相比,式(5)对少量极端异常点更稳健,有利于稳定训练。
在建模时将序列切分为固定长度窗口以捕捉局部层段结构。给定窗口长度L,从深度索引t开始的样本窗口定义为:
${X}_{t}=\left[\begin{array}{c}{\widehat{x}}_{t},{\widehat{x}}_{t+1},\dots,{\widehat{x}}_{t+L-1}\end{array}\right]\in {R}^{L\times F}$
式中:${\widehat{x}}_{t}$为归一化后的特征向量,Xt表示一个训练样本,滑动窗口使模型在学习So时能够利用上下文层段的连续性与响应形态特征。
1.2 含油饱和度标签与物理先验约束
监督回归的目标是学习从Xt到So序列的映射。若数据中存在解释得到的So或含水饱和度Sw,可以直接作为监督信号;当缺少标注时,引入岩石物理先验构造代理So,使得模型仍可在“物理可解释的近似标签”上训练并与物理模型进行对照分析。代理标签构造需要孔隙度估计。由密度曲线估计密度孔隙度:
${\varphi }_{D}\left(z\right)=\frac{{\rho }_{ma}-{\rho }_{b}\left(z\right)}{{\rho }_{ma}-{\rho }_{f}}, {\rho }_{b}\left(z\right)=\frac{DEN\left(z\right)}{1 000}$
式中:${\varphi }_{D}\left(z\right)$为密度孔隙度,ρma为基质密度,ρb(z)为体密度,ρf为孔隙流体密度。式中将DEN的单位从kg/m3转换到g/cm3以与ρma、ρf的常用单位一致。中子曲线常以孔隙度单位给出,近似为:
${\varphi }_{N}\left(z\right)=\frac{CNL\left(z\right)}{100}$
式中:${\varphi }_{N}\left(z\right)$为中子孔隙度估计。为了融合两类孔隙度信息并抑制单一曲线偏差,采用平均融合并进行物理范围截断:
$\varphi \left(z\right)=clip\left(\frac{{\varphi }_{D}\left(z\right)+{\varphi }_{N}\left(z\right)}{2},{\varphi }_{min},{\varphi }_{max}\right)$
式中:$\varphi \left(z\right)$为综合孔隙度估计,clip(·)为截断函数,${\varphi }_{min}$与${\varphi }_{max}$分别为孔隙度下限与上限。在清洁砂岩等适用条件下,采用Archie关系估计含水饱和度:
${S}_{w}\left(z\right)={\left(\frac{a{R}_{w}}{\varphi {\left(z\right)}^{m}{R}_{t}\left(z\right)}\right)}^{\frac{1}{n}}$
式中:Sw(z)为含水饱和度,Rw为地层水电阻率(Ω·m),a为曲折度系数,m为胶结指数,n为饱和度指数。由Sw得到含油饱和度:
${S}_{o}\left(z\right)=1-{S}_{w}\left(z\right)$
式(10)—(11)给出从测井电阻率与孔隙度到饱和度的经典映射,为无标注场景提供可解释的参考标签。
1.3 MWLT-So:自监督预训练与监督回归微调
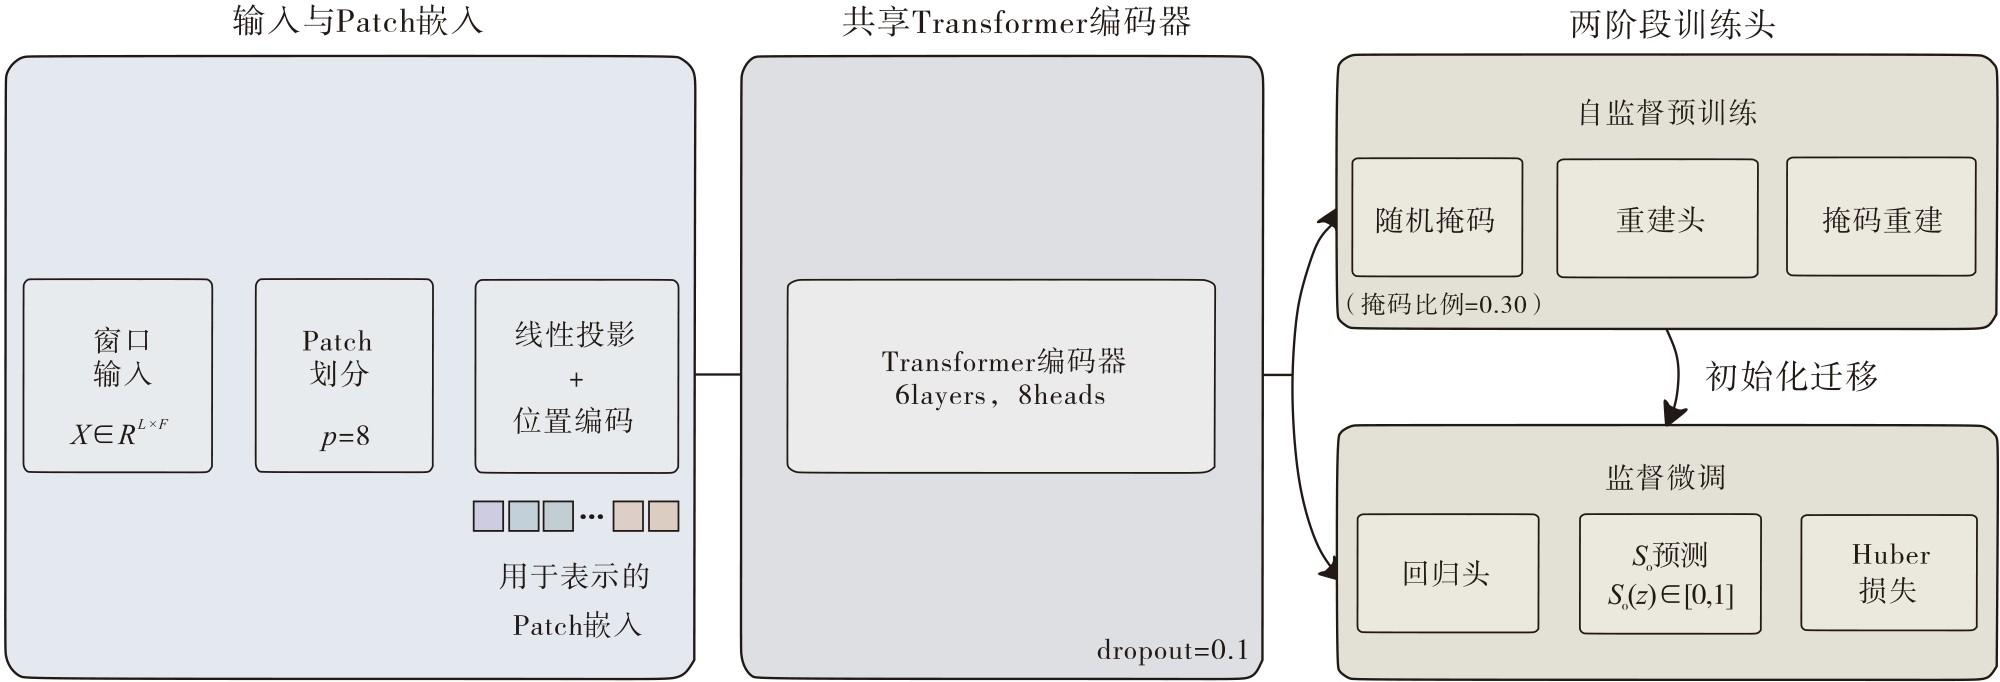
为了从测井序列中学习层段结构与跨曲线耦合,本文采用基于Transformer的MWLT-So框架。该框架在输入层采用patch化表示。
给定窗口${X}_{t}\in {R}^{L\times F}$,将其按深度方向划分为长度为p的patch,patch数为P =L/p。第i个patch的token表示为:
${e}_{i}={W}_{p}vec\left({X}_{t}\left[\left(i-1\right)p:ip\right]\right)+{b}_{p}+{e}_{i}^{pos}, i=1,\dots,P$
式中:vec(·)表示将patch展平为长度p的向量;${W}_{p}\in {R}^{d\times pF}$与${b}_{p}\in {R}^{d}$为可学习的线性投影参数;d为token维度;${e}_{i}^{pos}\in {R}^{d}$为位置编码,用于指示patch在窗口中的相对深度位置。Transformer编码器以自注意力机制为核心,在token序列上进行信息交互。单头注意力的计算形式为:
$Att\left(Q,K,V\right)=softmax\left(\frac{Q{K}^{\top }}{\sqrt{d}}\right)v$
式中:Q、K、V分别为查询、键和值矩阵,由token序列经过线性映射得到;分母$\sqrt{d}$用于缩放内积,避免随维度增长导致的softmax饱和。
自监督预训练阶段采用掩码建模策略。随机选取一部分patch组成集合Ω,将其token替换为可学习的mask token,并令模型重建被遮挡的曲线片段。预训练损失定义为:
${L}_{pre}=\frac{1}{\left|\Omega \right|}\sum _{i\in \Omega }{\left({\widehat{X}}_{i}-{X}_{i}\right)}_{2}^{2}$
式中:$\left|\Omega \right|$为被遮挡的patch数量,Xi为第i个patch的真实曲线片段,${\widehat{X}}_{i}$为模型重建结果。该目标迫使模型在没有标签的情况下学习测井序列的内在结构,为So回归提供更优的参数初始化。
监督微调阶段在预训练编码器基础上添加回归头,输出逐深度点的${\widehat{S}}_{o}\left({z}_{ }\right)$。考虑测井噪声与代理标签误差的存在,采用Huber损失进行优化:
${L}_{sup}=\frac{1}{N}\sum _{j=1}^{N}Huber\left({\widehat{S}}_{o}\left({z}_{j}\right)-{S}_{o}\left({z}_{j}\right);\delta \right)$
式中:N为样本点数$;\delta $为Huber阈值,用于在小误差时保持二次惩罚、在大误差时转为近似线性惩罚,从而提高对异常点的鲁棒性。模型输出通过sigmoid约束到[0,1]区间,以满足饱和度的物理边界条件。
为确保评估可靠性,数据划分采用井集划分策略,避免因深度相邻样本高度相关而导致的性能虚高。回归性能使用MAE、RMSE与决定系数R 2衡量:
$MAE=\frac{1}{N}\sum _{j=1}^{N}\left|{\widehat{y}}_{j}-{y}_{j}\right|, RMSE=\sqrt{\frac{1}{N}\sum _{j=1}^{N}{\left({\widehat{y}}_{j}-{y}_{j}\right)}^{2}}, {R}^{2}=1-\frac{\sum _{j=1}^{N}{\left({\widehat{y}}_{j}-{y}_{j}\right)}^{2}}{\sum _{j=1}^{N}{\left({y}_{j}-\dot{y}\right)}^{2}}$
式中:yj表示真实或代理So;${\widehat{y}}_{j}$为模型预测值;$\dot{y}$为真实均值。推理阶段采用重叠窗口预测并对重叠区域进行平均融合,以降低窗口边界效应并获得更平滑的So曲线。
2 实验与设计
2.1 数据集构成与曲线统计
本次研究以大庆油田N区块L井测井曲线及对应含油饱和度真值为基础构建监督学习数据集(表1)。数据覆盖的深度(TVD)范围为1 050~3 200 m,包含DEN、CNL、AC、Rt、GR曲线以及TVD信息。经数据清洗与标准化处理后,各测井曲线与含油饱和度标签在深度域上精确对齐。整体样本点数为395 462,曲线缺失与异常值占比处于可控范围,这为后续深度模型训练提供了足够的数据密度与有效信号。
表1 数据集与测井曲线汇总Table 1 Summary of dataset and well logging curves |
| 项 目 | 统 计 |
|---|---|
| 井数(总计) | 300 |
| 深度范围(TVD)/m | 1 050 ~3 200 |
| 采样间隔(Δz)/m | 原始 0.20~ 0.35;重采样 0.25 |
| 曲线类型 | DEN / CNL / AC / Rt (log10) / GR / TVD |
| 样本点数(总计) | 395 462 |
| 缺失率/% | DEN 1.3;CNL 1.7;AC 2.1;Rt 3.8;GR 1.1;总体 2.0 |
| 异常值比例/% | DEN 0.4;CNL 0.6;AC 0.8;Rt 1.2;GR 0.5;总体 0.7 |
| 训练井数/口 | 210 |
| 验证井数/口 | 60 |
| 测试井数/口 | 30 |
| 标签类型 | So真值 |
| 标签范围(So) | 最小值为 0.03;最大值为 0.98; 均值为 0.54;标准差值为 0.21 |
2.2 数据预处理与样本构建
本次研究采用统一的深度域预处理流程(图1):①将原始非等距采样重采样到Δz=0.25 m的等距深度网格,以保证不同井、不同曲线在深度域的对齐;②对缺失段进行插值/前后向填充以维持序列连续性;③对异常尖峰采用IQR分位截断抑制,以减少极端值对梯度与统计量的干扰;④对Rt执行log10(Rt)以削弱长尾分布并增强与孔隙结构相关的可学习性;⑤采用median与IQR进行鲁棒归一化,使得模型更关注层段形态与多曲线耦合。
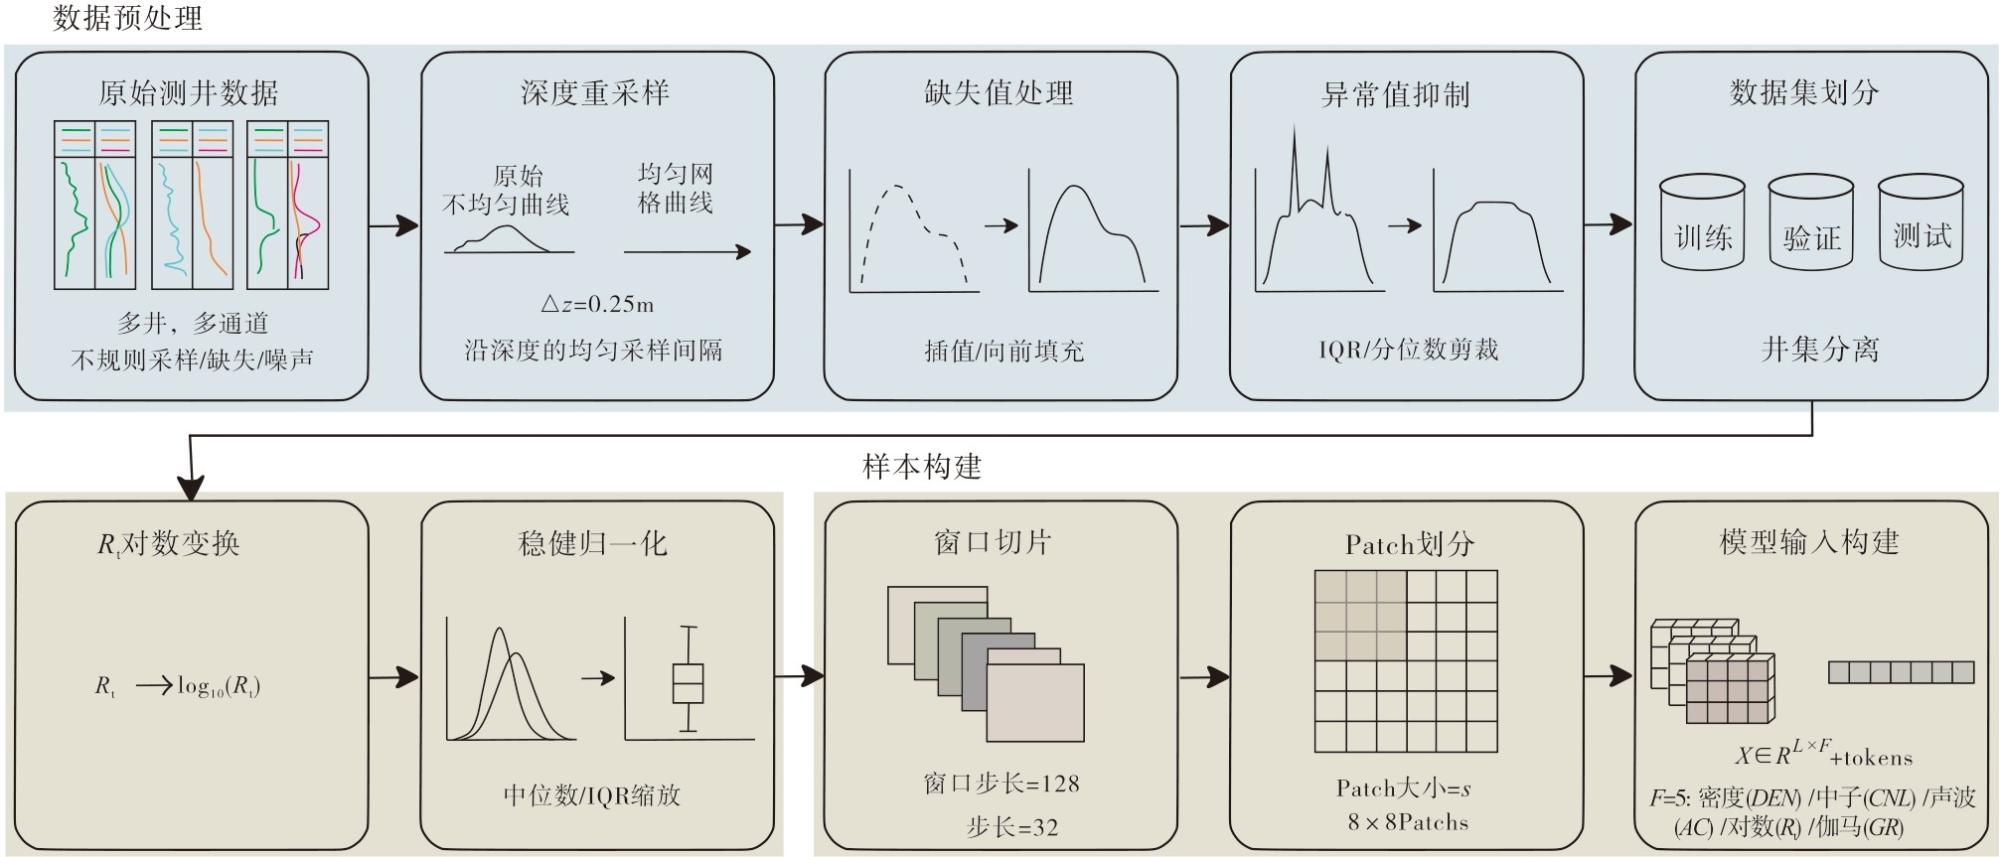
在样本构建方面,采用滑动窗口切片策略将连续深度序列转化为监督学习样本(图2)。该设计能够在保持局部测井形态的同时,通过自注意力机制建模长程依赖与多曲线耦合关系,为后续自监督预训练与So回归微调提供统一输入形式。
2.3 按井划分策略与防泄漏设计
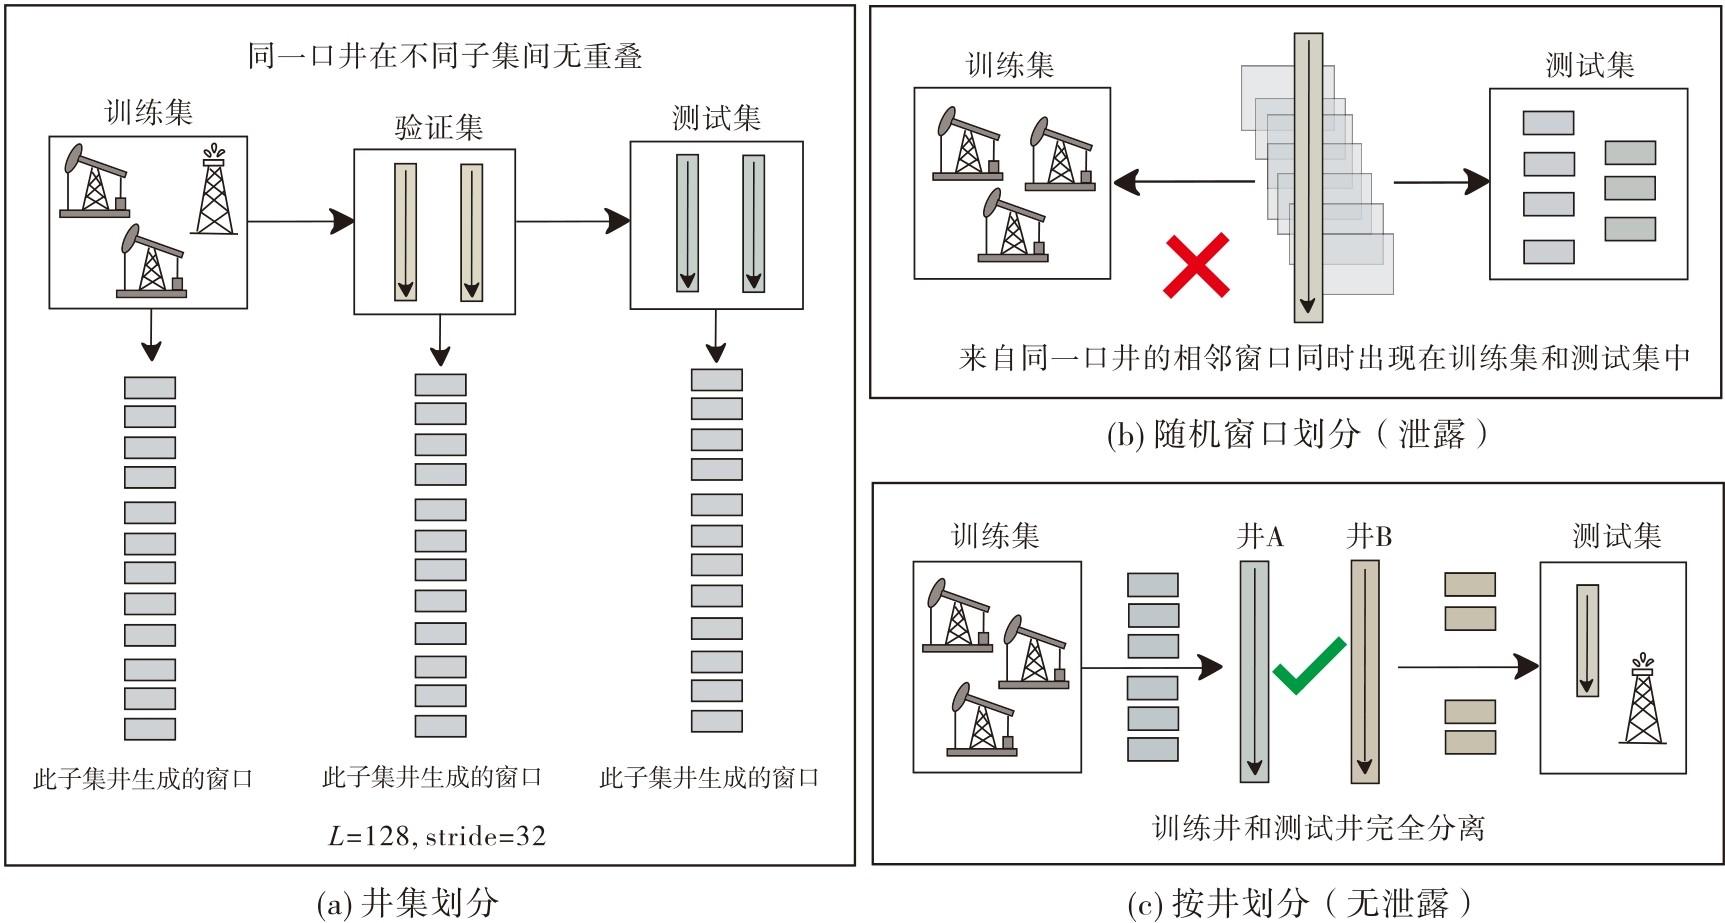
2.4 模型与训练超参数设置
MWLT-So模型采用两阶段训练范式(表2):首先在无标签条件下进行掩码自监督预训练,使模型学习测井曲线的层段连续性与多曲线耦合响应关系,以具备跨井泛化能力的通用表征;随后在So回归任务上监督微调,使表征对目标任务进行有监督对齐。模型骨干为Transformer Encoder,能够在token序列上捕捉非局部依赖与跨曲线关联。预训练阶段随机遮蔽30%的patch并以masked MSE重建,仅在被遮蔽位置计算误差;微调阶段使用Huber损失兼顾鲁棒性与收敛稳定性。训练采用AdamW与余弦退火+warmup,结合AMP混合精度、梯度裁剪与早停策略控制训练稳定性与过拟合风险。
表2 模型与训练超参数设置Table 2 Model and training hyperparameter settings |
| 类 别 | 超 参 数 | 取 值 |
|---|---|---|
| 输入设置 | 窗口长度 L | 128 |
| stride(滑窗步长) | 32 | |
| patch 大小 p | 8 | |
| 特征维度 F | 5(DEN/CNL/AC/Rt(log10)/GR) | |
| 模型结构 | d_model | 128 |
| Transformer 层数(layers) | 6 | |
| 注意力头数(heads) | 8 | |
| dropout | 0.1 | |
| 自监督预训练 | mask 比例(mask ratio) | 0.30 |
| batch size(pretrain) | 128 | |
| epochs(pretrain) | 100 | |
| 学习率(pretrain) | 1×10⁻⁴ | |
| 预训练损失函数 | masked MSE | |
| 监督微调(So回归) | batch size(finetune) | 64 |
| epochs(finetune) | 80 | |
| 学习率(finetune) | 3×10⁻⁴ | |
| 优化器 | AdamW | |
| 权重衰减 | 1×10⁻⁵ | |
| 学习率策略 | Cosine + Warmup(10%) | |
| 损失函数 | Huber(δ=0.5) | |
| 训练控制 | AMP 混合精度 | 开 |
| 梯度裁剪(grad clip) | 1.0 | |
| 早停策略 | 监控 val loss;patience=10;min_delta=1×10⁻⁴ | |
| 数据划分 | 划分方式 | 按井划分(train/val/test) |
2.5 对比方法设置与评价指标体系
为了从物理模型、传统机器学习与深度序列模型3个层面对比验证本文方法的优势,设置Archie作为物理基线,LR、RF、GBDT/XGBoost作为非序列机器学习对比,LSTM/GRU作为序列深度学习基线(表3)。不同方法输入形式各异:物理基线依赖ϕ与Rt,传统机器学习以同深度点多曲线特征回归So,序列模型以窗口序列L×F回归So。本文方法在窗口序列基础上进一步token化并引入自监督预训练以增强泛化。
表3 不同方法特点与对比Table 3 Features and comparison of different methods |
| 方法 | 输入特征 | 是否用序列 | 是否自监督 | 训练成本 | 可解释性 |
|---|---|---|---|---|---|
| Archie | ϕ,Rt | 否 | 否 | 低 | 高 |
| LR | DEN/CNL/AC/Rt(log10)/GR | 否 | 否 | 低 | 中 |
| RF | DEN/CNL/AC/Rt(log10)/GR | 否 | 否 | 中 | 中 |
| GBDT/XGBoost | DEN/CNL/AC/Rt(log10)/GR | 否 | 否 | 中—高 | 中 |
| LSTM/GRU | 窗口序列 L×F | 是 | 否 | 高 | 中—低 |
| MWLT-So | 窗口序列 L×F→ patch token | 是 | 是(MWLT掩码) | 高(泛化强) | 中 |
3 结果与讨论
3.1 回归主结果
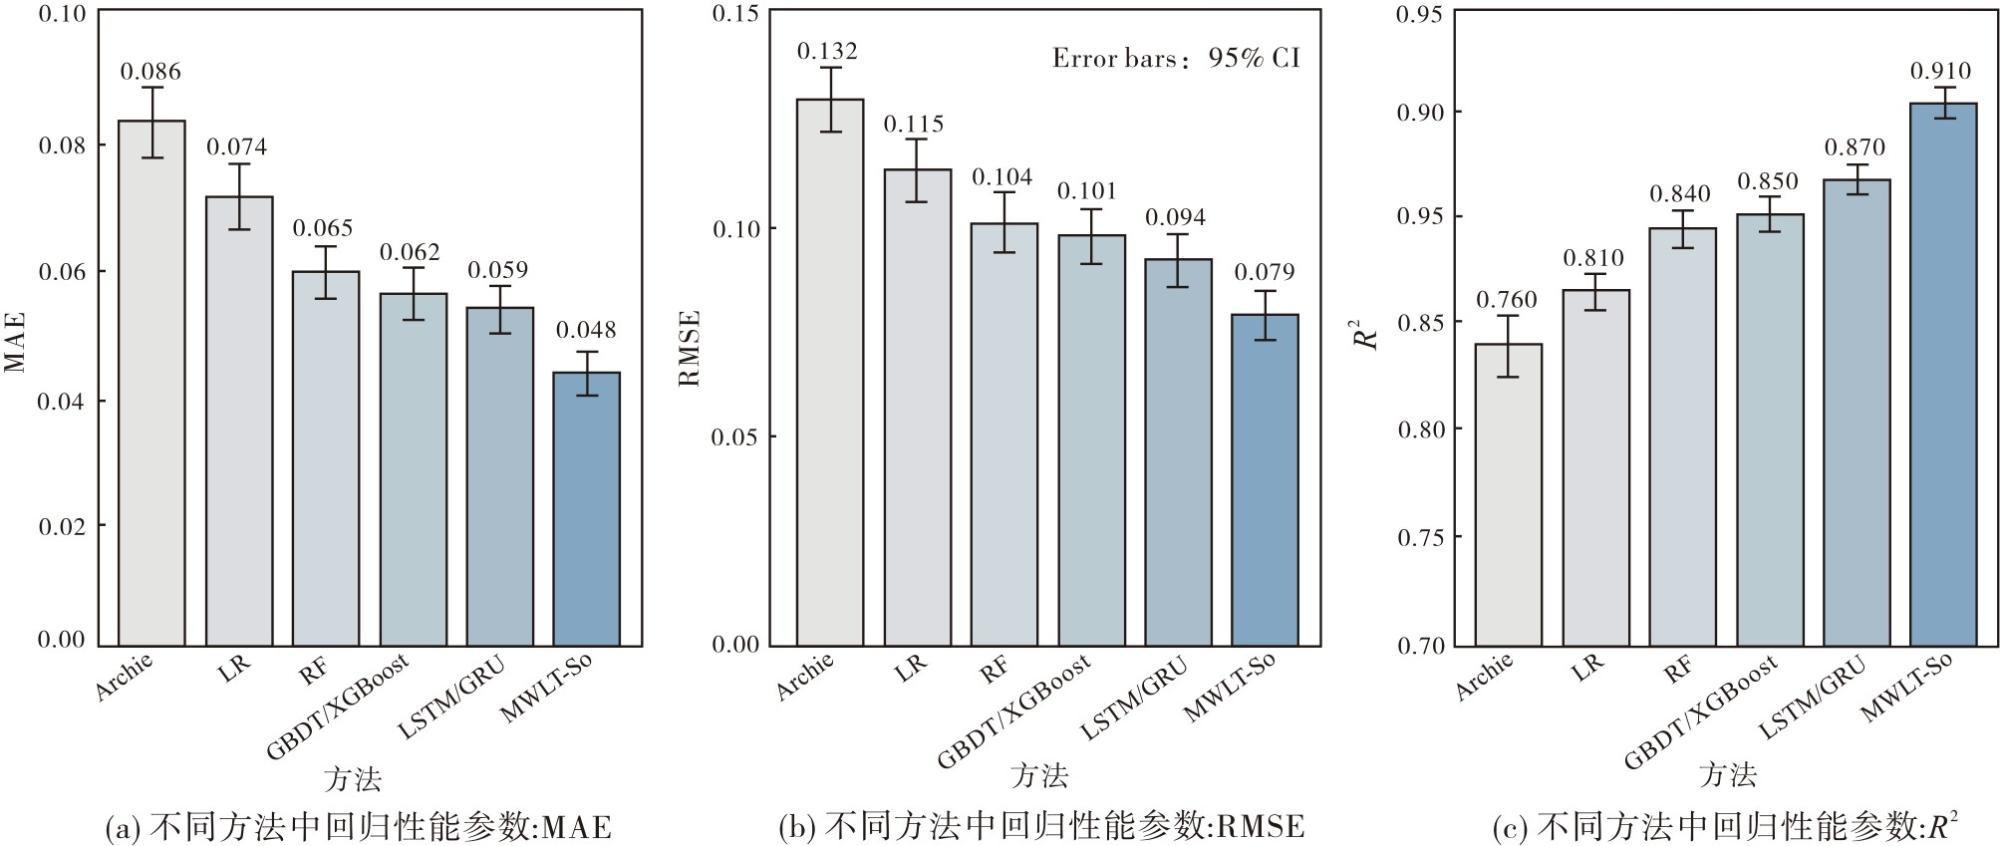
在按井划分的严格评估条件下,各方法回归性能如表4所示。物理基线Archie总体回归性能参数RMSE值为0.132,说明仅依赖物理关系在复杂井段与多曲线耦合条件下存在偏差累积;传统机器学习能力显著提升,GBDT/XGBoost作为其中最强基线总体RMSE达到0.101;序列模型LSTM/GRU利用窗口上下文进一步将总体RMSE降低至0.094。MWLT-So最优,置信区间更小,表明其不仅平均误差更低,且预测波动更小、更稳定。与Archie相比总体RMSE相对提升40.2%,体现掩码自监督预训练带来的表征泛化能力对跨井回归任务具有关键作用。
表4 各方法预测性能总对比Table 4 Overall comparison of prediction performance of different methods |
| 方法 | MAE (按井平均) | RMSE (按井平均) | R² (按井平均) | MAE (总体) | RMSE (总体) | R²(总体) | 相对提升/%(RMSE,总体) | 置信区间 (95%) |
|---|---|---|---|---|---|---|---|---|
| Archie | 0.083 | 0.127 | 0.78 | 0.086 | 0.132 | 0.760 | 基线 | ±0.018 |
| LR | 0.071 | 0.112 | 0.82 | 0.074 | 0.115 | 0.810 | 12.9 | ±0.016 |
| RF | 0.063 | 0.102 | 0.85 | 0.065 | 0.104 | 0.840 | 21.2 | ±0.015 |
| GBDT / XGBoost | 0.061 | 0.099 | 0.86 | 0.062 | 0.101 | 0.850 | 23.5 | ±0.014 |
| LSTM / GRU | 0.058 | 0.093 | 0.88 | 0.059 | 0.094 | 0.870 | 28.8 | ±0.013 |
| MWLT-So | 0.046 | 0.078 | 0.92 | 0.048 | 0.079 | 0.910 | 40.2 | ±0.011 |
为了更直观对比3类指标,图4将MAE、RMSE、R²以一致尺度呈现,并在误差线上体现95%置信区间。MWLT-So在3项指标上均为最优(MAE越小越好,RMSE越小越好,R2越大越好),且置信区间最短,进一步支持其“高精度+高稳定性”的结论。
3.2 训练过程与收敛特性
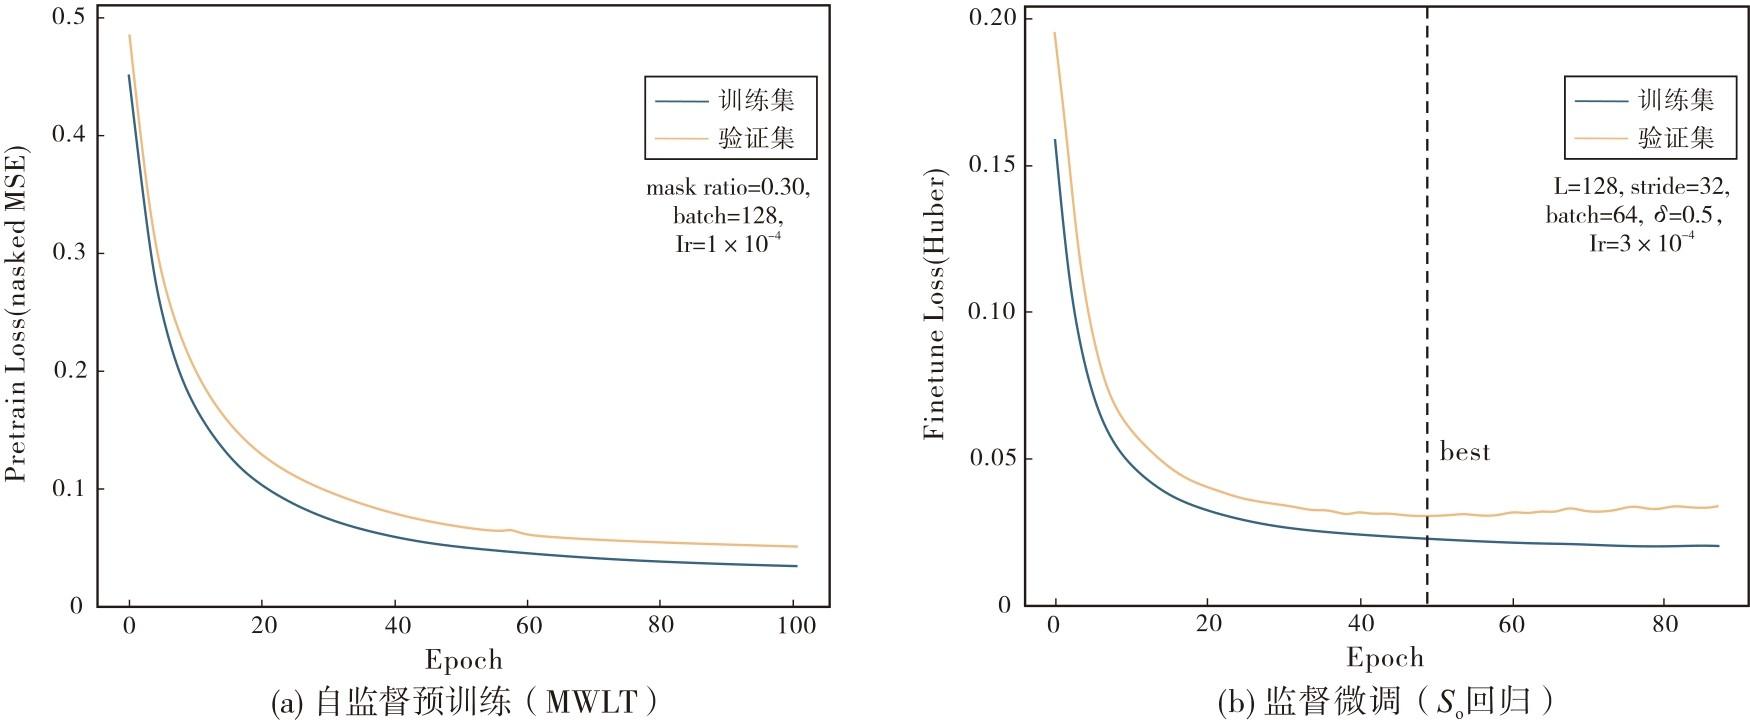
两阶段训练的收敛曲线如图5所示。自监督预训练阶段,训练与验证loss同步下降并逐步趋于平稳,说明模型能够在无标签条件下学习测井曲线的可预测结构,从而形成有效初始化;在监督微调阶段,loss在前期快速下降、后期趋于稳定,验证曲线未出现明显反弹,表明模型在跨井划分下未发生严重过拟合。
3.3 全井预测对比
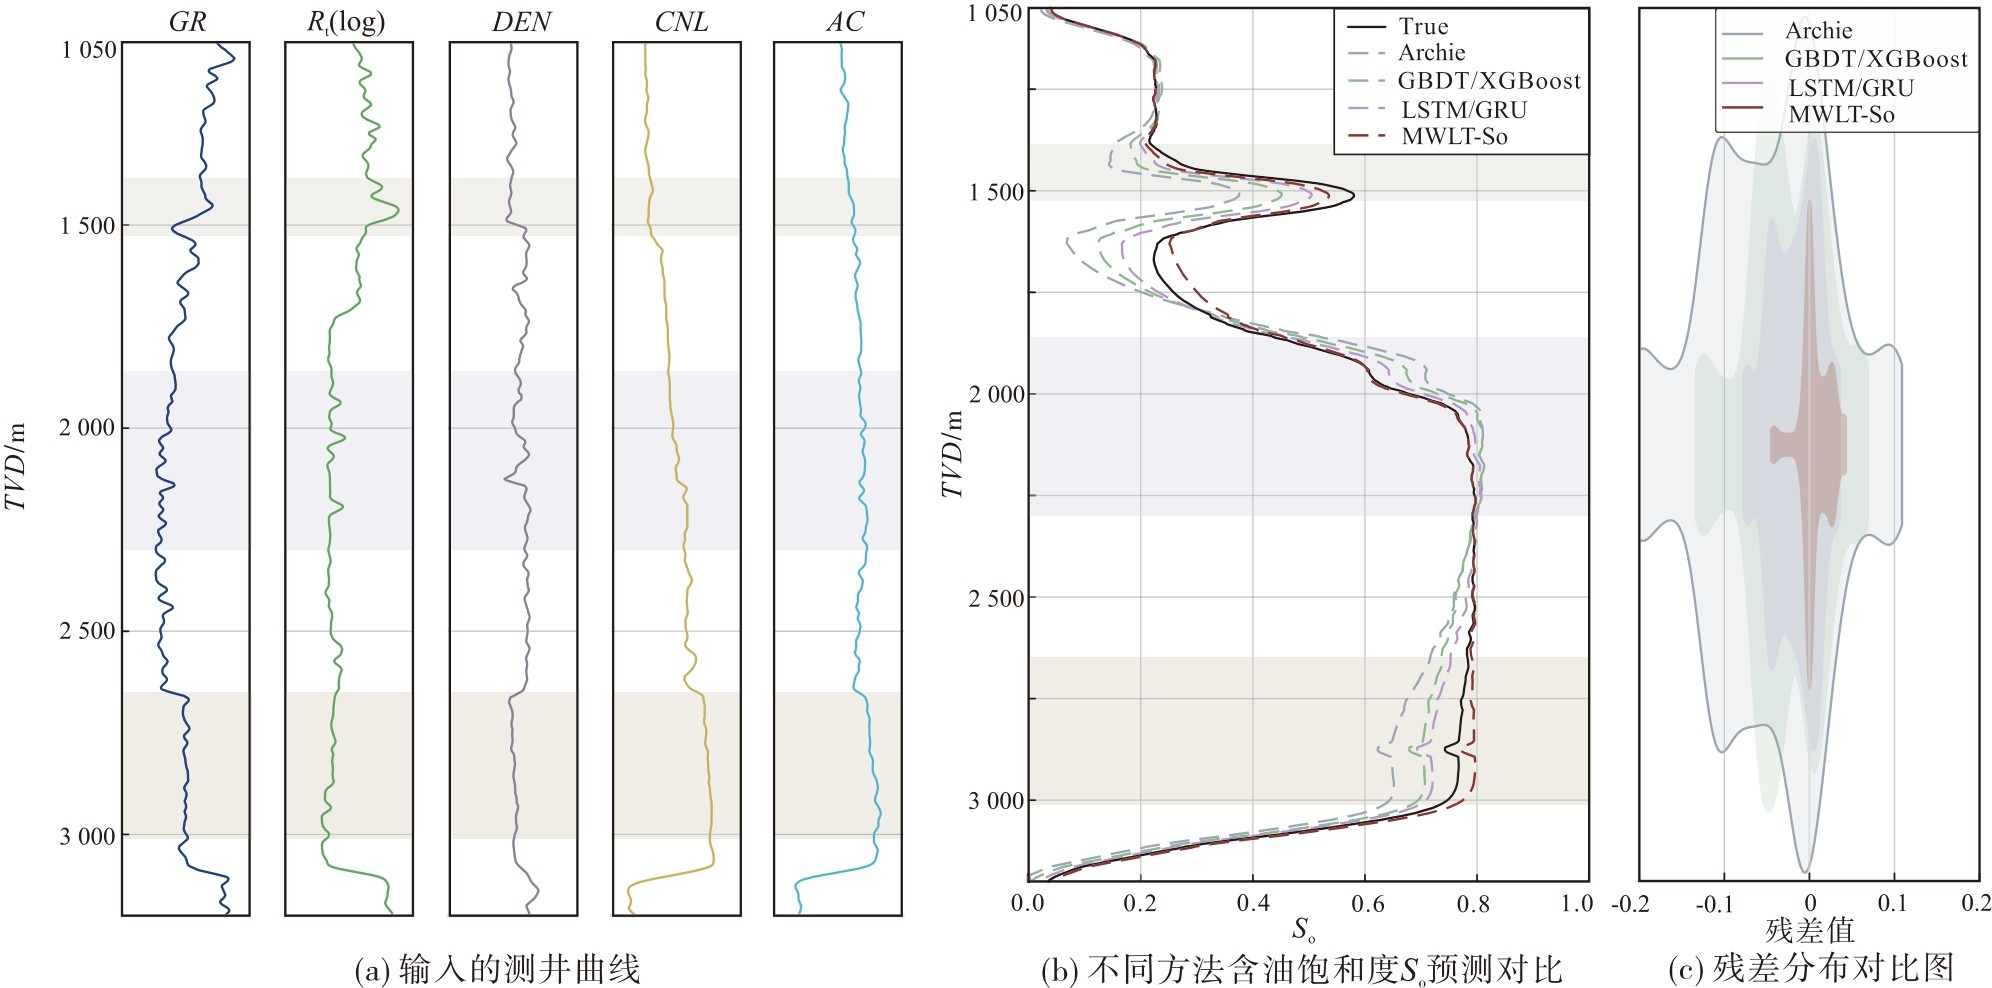
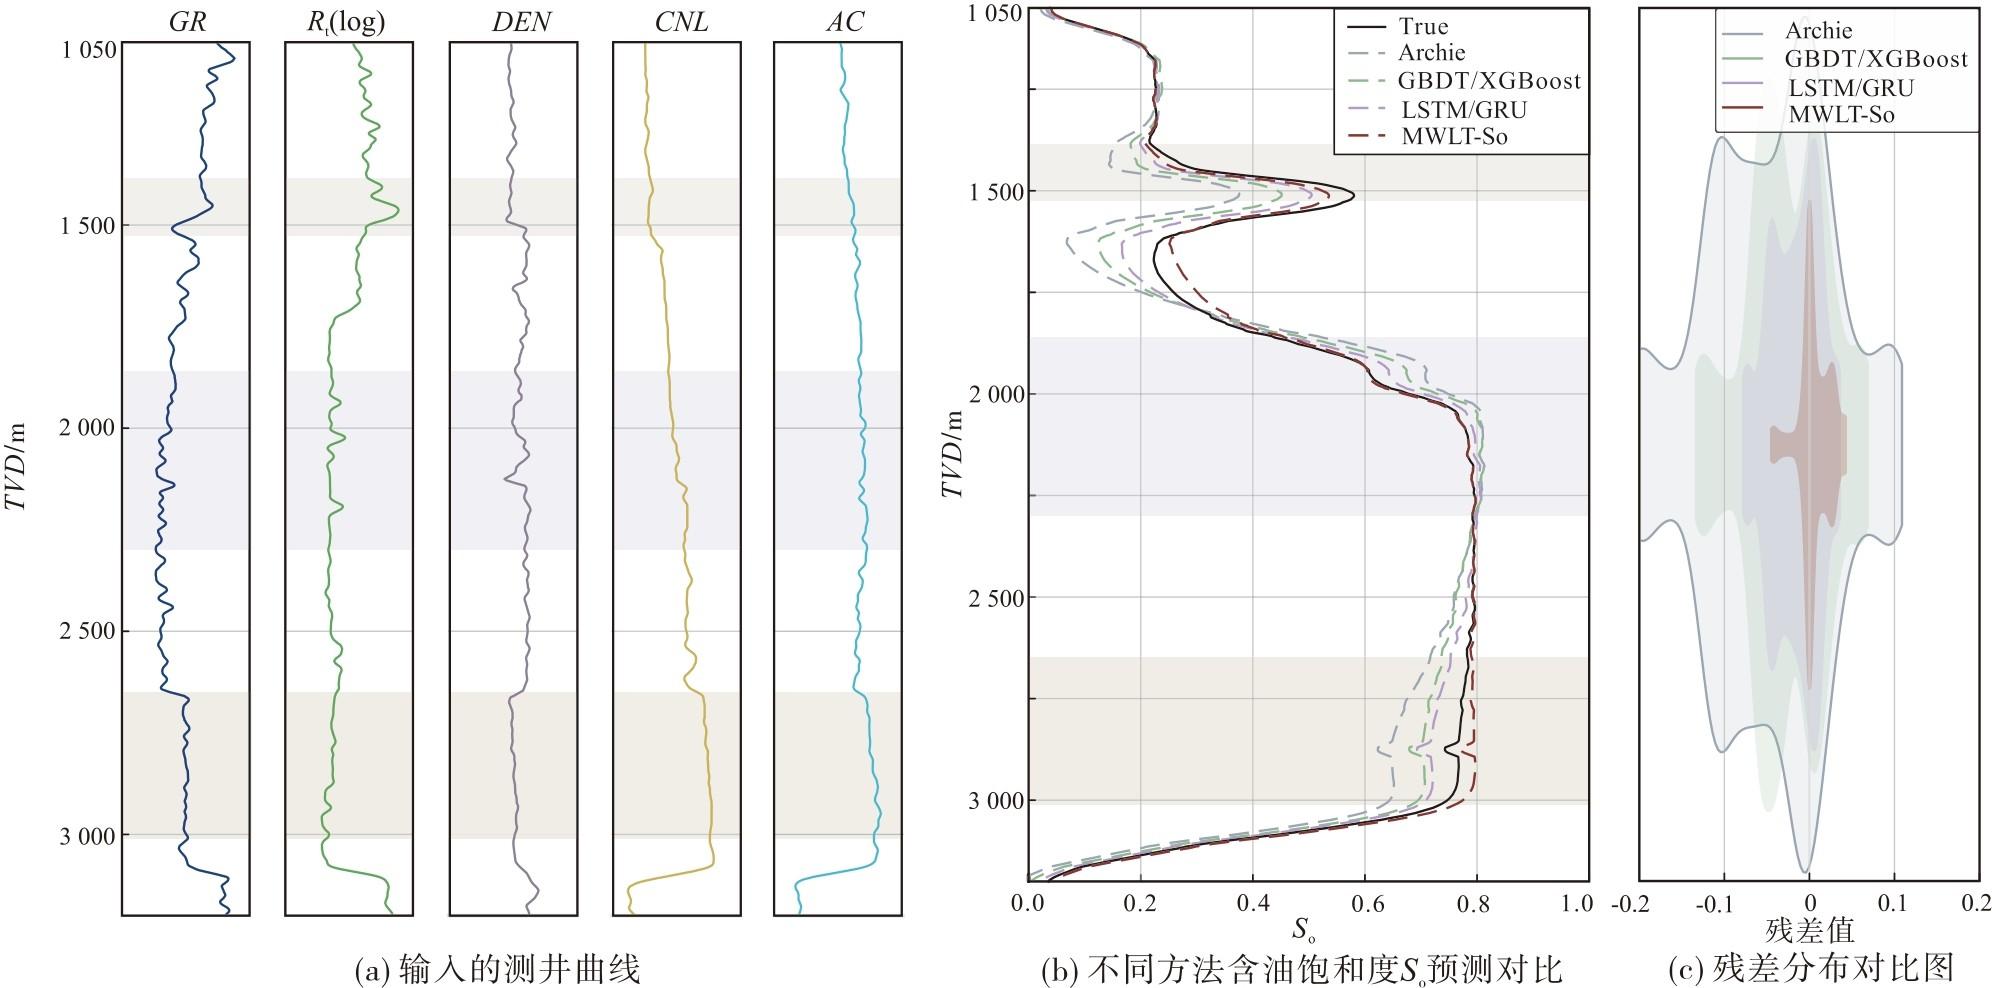
模型是否能在全井范围稳定输出并准确刻画层界过渡,峰值与低值段是比“单一指标更优”更关键的评价维度。图6显示MWLT-So在层界处的转折位置更贴近真值,在高So平台与峰值段偏差更小,并且残差分布更集中于零附近,说明其对“形态+幅值”的同步拟合能力更强。
3.4 Pred-True散点揭示误差结构
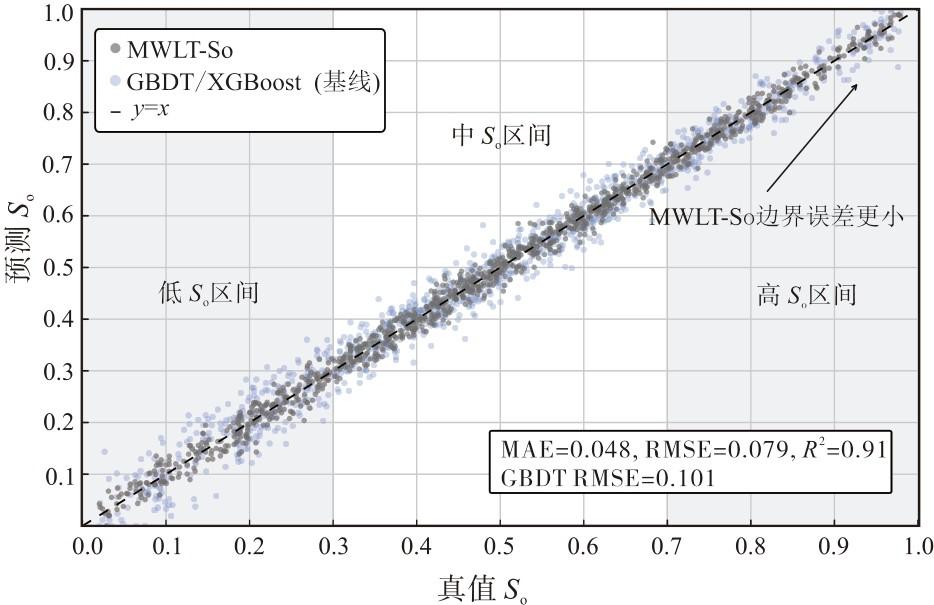
图7中MWLT-So点云整体更集中且在高So区间仍保持较小离散,说明其在油层高饱和度段的预测更稳健。
3.5 表征空间对比
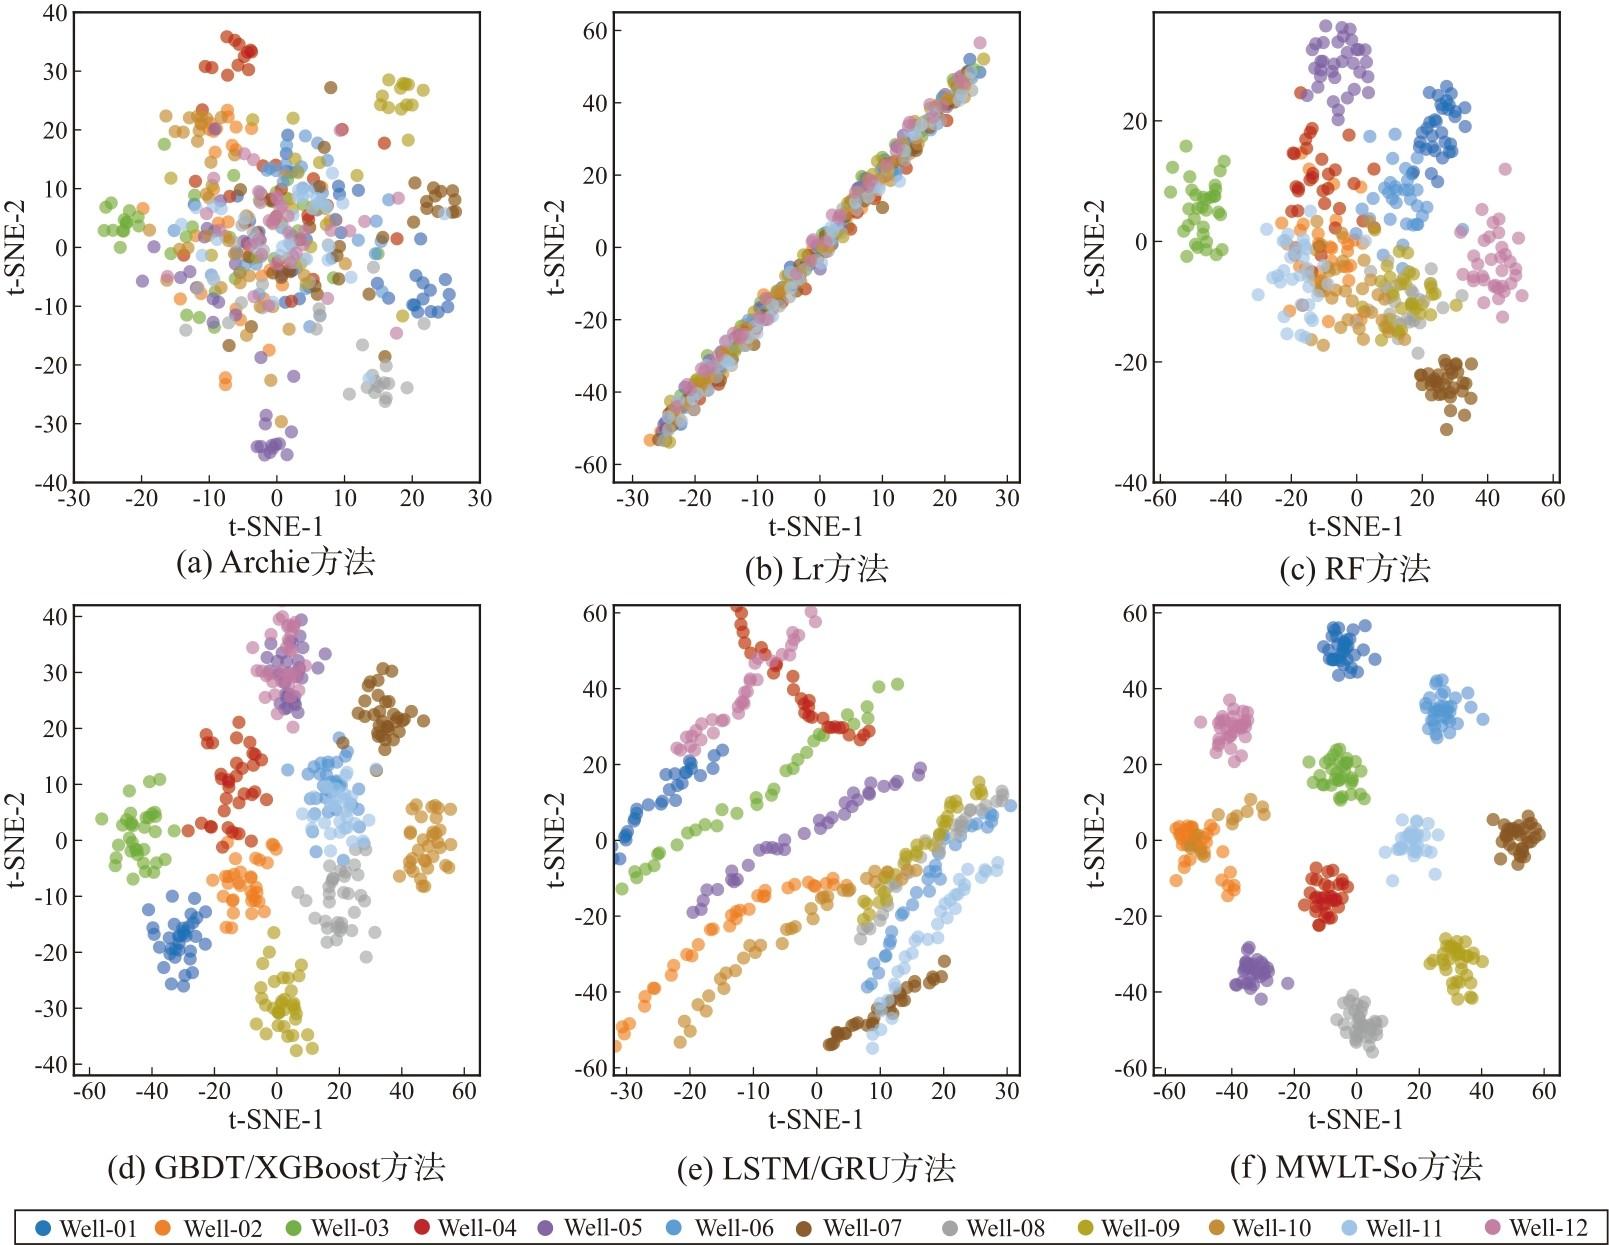
为解释“为什么同样是序列模型,MWLT-So优于LSTM/GRU”这一问题,对不同方法的特征表征进行t-SNE投影对比(图8)。若表征空间主要按井编号分裂,说明井间分布漂移较强,模型难以学习跨井一致的特征;若不同井在同一簇内充分混合且簇结构更紧凑,说明表征更具通用性与可迁移性。各种方法中,MWLT-So表征更紧凑且跨井混合更充分,说明掩码自监督预训练有效缓解了井间分布差异,使得微调阶段能够以更少的监督信号实现更强泛化。
3.6 单井局部剖面与误差稳定性
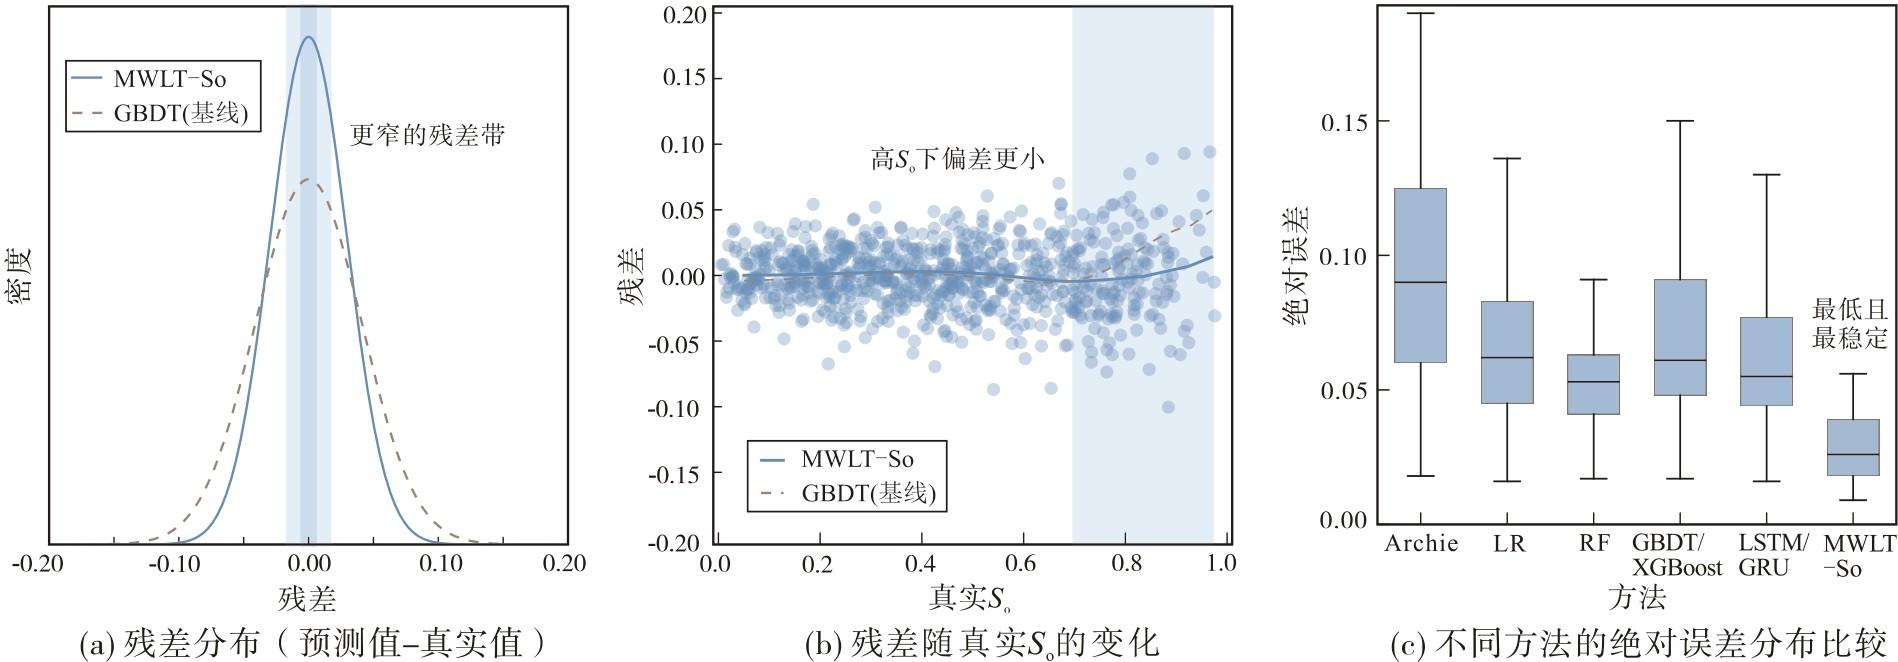
图9从残差分布、残差随真值变化与绝对误差分布3个维度刻画稳定性:MWLT-So残差更集中、尾部更短、在高So区偏差更小,并在绝对误差分布上呈现更低的中位数与更小的离散范围。这意味着模型不仅均值更好,也具备更低的极端误差风险。
3.7 阈值分层油层识别
在实际油层评价中,常需将连续含油饱和度预测结果通过阈值转换为“油层与非油层”进行判别。不同区块的岩性组合、孔隙结构与电性响应存在差异,工程应用中的判别阈值通常需要随区块进行校准。为评估回归输出在不同工程阈值下的可用性与稳定性,对阈值t ∈[0.40,0.60]进行扫描,并将So≥t定义为油层判别条件。对每一个阈值t,分别将真值So与模型预测So转换为二分类标签,统计真阳性(TP)、假阳性(FP)、真阴性(TN)、假阴性(FN)值,并计算准确率与F1值。
鉴于F1分数对正负样本分布变化具有较强鲁棒性,能够更为稳健地衡量模型的综合识别能力,本研究选取F1作为主要评价指标,并结合准确率进行综合研判。在此基础上,为兼顾与既有研究成果及常用经验阈值的可比性,系统考察了不同阈值下油层的识别性能。综合准确率与F1随阈值变化的整体走势,当阈值t =0.50时,两项指标均处于较优水平且表现均衡(表5),因此选定其为最具代表性的决策阈值。
表5 不同阈值下的油层识别性能(t =0.40~0.60)Table 5 Oil-layer identification performance under different thresholds (t =0.40~0.60) |
| 阈值 t | 准确率/% | 预测率/% | 召回率/% | F1值 |
|---|---|---|---|---|
| 0.40 | 85.8 | 92.0 | 95.5 | 0.937 |
| 0.45 | 86.6 | 93.5 | 94.3 | 0.939 |
| 0.50 | 87.1 | 94.8 | 93.2 | 0.940 |
| 0.55 | 86.7 | 95.8 | 91.5 | 0.936 |
| 0.60 | 86.2 | 97.0 | 89.0 | 0.928 |
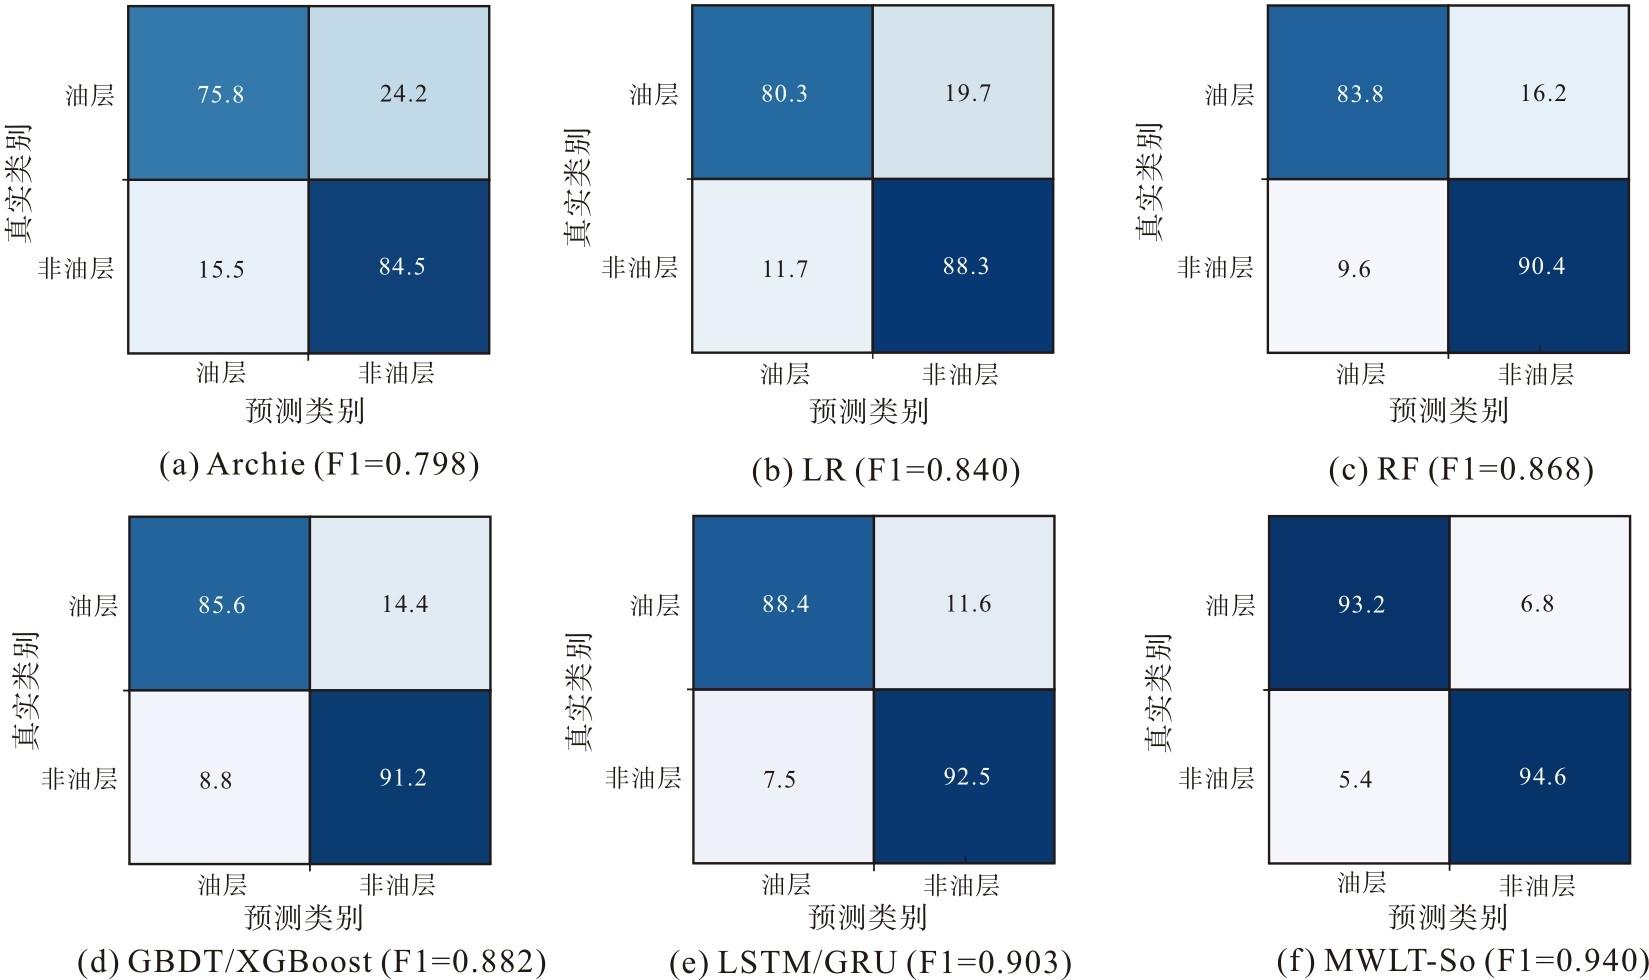
各方法在该阈值下的TP、FP、TN、FN以及准确率、预测率、召回率和F1值见表6,其中,Archie方法的准确率和F1分别为68.0%和0.798,整体表现相对较弱;相比之下,LR、RF以及GBDT/XGBoost等方法均在此基础上取得了不同程度的性能提升,其中RF方法和GBDT/XGBoost方法在综合表现上更具优势。
表6 不同方法的油层识别结果比较(So=0.5)Table 6 Oil-layer identification results of different methods (So=0.5) |
| 方法 | 真阳性(TP) /% | 假阳性(FP)/% | 真阴性(TN)/% | 假阴性(FN)/% | 准确率/% | 预测率/% | 召回率/% | F1值 |
|---|---|---|---|---|---|---|---|---|
| Archie | 67.8 | 12.5 | 68.3 | 21.7 | 68.0 | 84.4 | 75.8 | 0.798 |
| LR | 73.9 | 9.6 | 72.4 | 18.1 | 73.1 | 88.5 | 80.3 | 0.840 |
| RF | 77.5 | 8.2 | 76.8 | 15.0 | 77.2 | 90.4 | 83.8 | 0.868 |
| GBDT/XGBoost | 79.1 | 7.6 | 78.3 | 13.3 | 78.8 | 91.2 | 85.6 | 0.882 |
| LSTM/GRU | 82.3 | 6.5 | 80.4 | 10.8 | 81.5 | 92.7 | 88.4 | 0.903 |
| MWLT-So | 88.6 | 4.9 | 85.7 | 6.5 | 87.1 | 94.8 | 93.2 | 0.940 |
图10的混淆矩阵进一步展示了各模型的误判结构。由混淆矩阵对比可见,随着模型由传统经验公式和浅层机器学习方法逐步发展到深度时序模型,再到本文提出的MWLT-So方法,矩阵对角线区域的占比持续增加,非对角线误判不断减少,表明模型对油层与非油层的区分能力逐步增强。这一递进趋势不仅反映了模型复杂度提升带来的拟合能力增益,更体现了从“静态特征匹配”向“动态时序模式挖掘”的范式转变。其中,Archie方法误判最为明显,尤其是将油层误判为非油层的比例较高,导致召回率偏低;LR和RF在整体识别性能上有所提升,但仍存在较为明显的类别混淆;GBDT/XGBoost进一步优化了分类边界,使油层与非油层的识别更加均衡;LSTM/GRU通过建模测井曲线的序列特征,显著降低了两类之间的交叉误判。相比之下,MWLT-So表现最佳,其混淆矩阵对角线占比最高、非对角项最低,说明该方法不仅能够更准确地识别油层,而且能够有效抑制非油层误报,体现出更强的综合判别能力和更高的实际应用潜力。
4 结论
(1)针对测井曲线驱动的含油饱和度So反演问题,提出MWLT-So两阶段深度学习框架:首先通过掩码自监督预训练在无标签条件下学习测井序列的层段连续性与多曲线耦合表征,其后在有限标注So上进行监督微调以完成回归映射。该范式在输入窗口化与patch化表示下实现了“通用表征学习—任务适配”的统一建模路径,为跨井泛化提供了机制支撑。
(2)在数据集与按井划分的严格评估设置下,MWLT-So在回归主任务上取得最优性能。与物理基线Archie相比总体RMSE相对提升40.2%,同时优于传统机器学习方法与序列深度学习基线,表明自监督表征学习能够显著降低跨井分布漂移对回归误差的影响,并提升预测精度与稳定性。
(3)从地质剖面一致性与误差结构角度,MWLT-So具有更大优势:在地质响应方面,无论在全井还是单井对齐,对比中对层界过渡带与高So平台段的拟合更为贴近真值;在误差形态方面,能够有效抑制传统方法常见的过平滑、边界过冲与相位滞后等现象;在统计分布方面,残差分布更集中、尾部更短,绝对误差分布的中位数与离散度均更低。这表明该方法在降低平均误差的同时,也降低了极端误差风险,具备更强的工程解释可靠性。
(4)进一步将连续So回归结果通过阈值So=0.5转换为油层/非油层识别任务,MWLT-So 仍表现出最优分类性能,且混淆矩阵中假阳性(FP)与假阴性(FN)最低,表明该模型能够在阈值分层场景下能有效降低误判与漏判风险,具备在油层分层识别与储层评价等工程应用中的推广潜力。